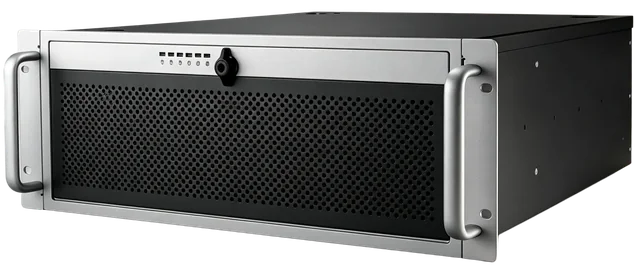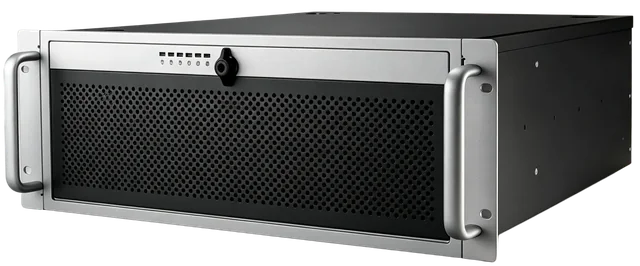
AI 自训练服务器
AI自训练服务器是面向企业的一站式AI开发平台,为机器学习与深度学习提供海量数据预处理及交互式智能标注、 大规模分布式训练、自动化模型生成,及端-边-云模型按需部署能力。 平台支持 TensorFlow、PyTorch、PaddlePaddle 等主流AI开发框架, 底层支持 NVIDIA GPU、Atlas 500 等异构计算资源。 内置 双路 RTX 4080 GPU,每路配备 16GB GDDR6X 显存、9728 CUDA 核心, Intel Xeon E5-2680 v3 十二核处理器,帮助用户快速创建和部署模型,管理全周期AI工作流。
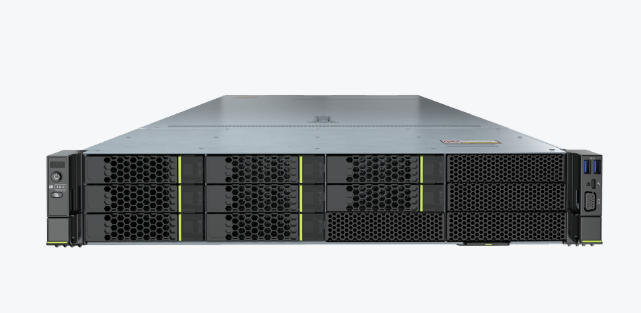
硬件规格
| 产品名称 | AI自训练服务器 |
|---|---|
| CPU | Intel Xeon E5-2680 v3,12核24线程,2.5GHz基础频率,3.3GHz睿频 |
| 内存 | 64GB ECC(32GB × 2) |
| 固态硬盘 | 512GB SSD |
| 主板 | 工业级主板 |
| GPU | RTX 4080 × 2,16GB GDDR6X,9728 CUDA核心 |
| 浏览器支持 | IE8+, Chrome 31-44, Firefox 30-51, Safari 8.0+ |
| 网络协议 | TCP/IP, ICMP, HTTP, HTTPS, FTP, DHCP, DNS, DDNS, RTP, RTSP, RTCP, NTP, UPnP, SMTP, SNMP, IGMP, 802.1X, QoS, IPv6, UDP |
| 操作系统 | Linux |
| 视频输出 | 1×HDMI,1×VGA |
| 音频输出 | 1路 RCA |
| 语音对讲输入 | 1个 RCA |
| 网络接口 | 2×千兆以太网口 |
| USB接口 | 2×USB 3.0 |
| 电源 | AC100V ~ 240V |
| 功耗 | ≤140W |
| 尺寸 | 482 × 479 × 177mm(标准机架式) |
平台功能
AI模型全生命周期管理
平台为AI模型提供完整的生命周期管理、运维监控和在线升级服务,从模型创建到推送形成完整闭环。
创建模型
填写模型名称、联系方式、功能描述等信息,即可快速创建模型。
AI模型训练
使用标注后的数据集进行迭代训练,支持临时版本号管理。
AI模型发布
审核确认模型版本,确定最终发布版本号和参数文件。
AI模型更新与推送
将发布的AI模型与视频资源配置绑定,下发到端侧进行实时识别,提供完整生命周期管理。
AI推理
AI摄像仪、边缘计算装置和推理服务器收到模型后,对场景进行算法推理,结果发送到管理平台。
从模型创建 → 迭代训练 → 发布 → 更新推送 → 推理,形成完整闭环
典型应用场景
企业AI研发
一站式模型开发
快速迭代 · 降本增效
高校科研
教学实训 · 学术研究
多框架支持 · 灵活调度
工业视觉
缺陷检测 · 质量管控
模型定制 · 边端部署
智慧安防
人脸识别 · 行为分析
算法训练 · 实时推理